Ingénierie29 min de lecture
Prompt engineering : parler à une IA qui oublie tout
Types de prompts, format, mémoire, tokens, modèles et paramètres : le prompt engineering sans jargon, en construisant un chef qui cuisine les restes du frigo.
Loïc Simon
Développeur Fullstack
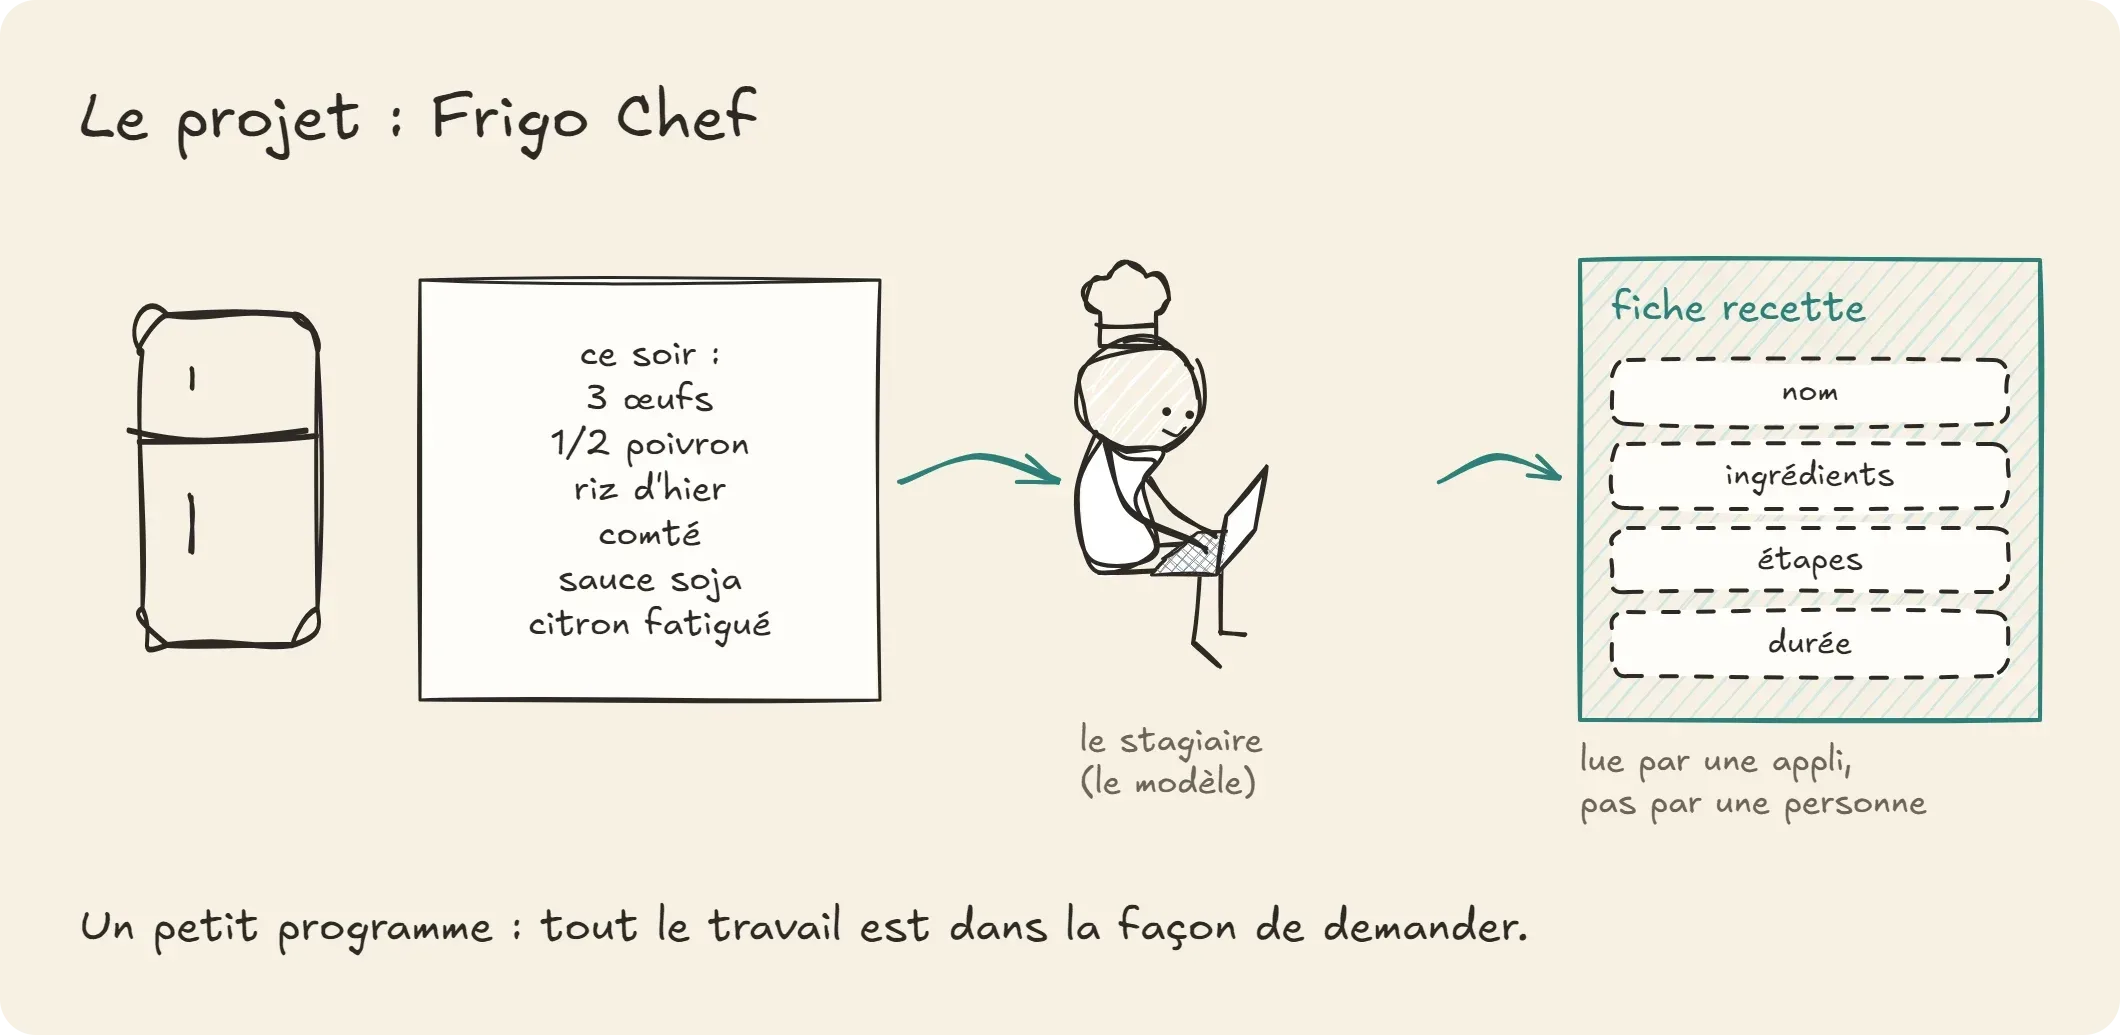
Ce soir, dans mon frigo, il y a trois œufs, un demi-poivron rouge, un bol de riz cuit d'hier, un reste de comté, de la sauce soja et un citron un peu fatigué. La question est aussi vieille que les frigos : qu'est-ce qu'on mange ?
On va construire ensemble un petit programme pour y répondre. Appelons-le Frigo Chef. On lui donne le contenu du frigo, et une IA renvoie une fiche recette qu'une appli peut afficher : un nom, les ingrédients, les étapes, la durée. Quelques lignes de texte, pas de base de données, pas d'interface. Tout le travail est dans la façon de demander.
C'est exactement ce qu'on appelle le prompt engineering : l'art de rédiger ce qu'on demande à un modèle de langage (un LLM, comme ChatGPT, Claude ou Gemini) pour obtenir ce qu'on veut, au format qu'on veut. Chaque étape de Frigo Chef va nous faire croiser une notion : les types de prompts, le format de sortie, la mémoire, les tokens, les différences entre modèles, la température. Pas besoin d'être développeur. Pour chaque sujet, je vous laisse un lien vers un guide plus technique, si vous voulez creuser.
Et comme je n'aime pas les recettes qu'on n'a pas goûtées, j'ai fait tourner chaque étape pour de vrai, le 21 octobre 2026 : 157 appels via OpenRouter, presque tous à trois petits modèles bon marché, pour un total de 7 centimes de dollar. Les chiffres de cet article viennent de là.
Le modèle mental : un stagiaire brillant qui oublie tout
Pour savoir comment parler à un LLM, il faut une image de ce qu'il est. La documentation d'Anthropic, qui fabrique Claude, en propose une très juste : traitez le modèle comme un employé brillant mais nouveau, qui ne connaît pas vos habitudes ni votre façon de travailler. Plus vous expliquez précisément ce que vous voulez, meilleur est le résultat.
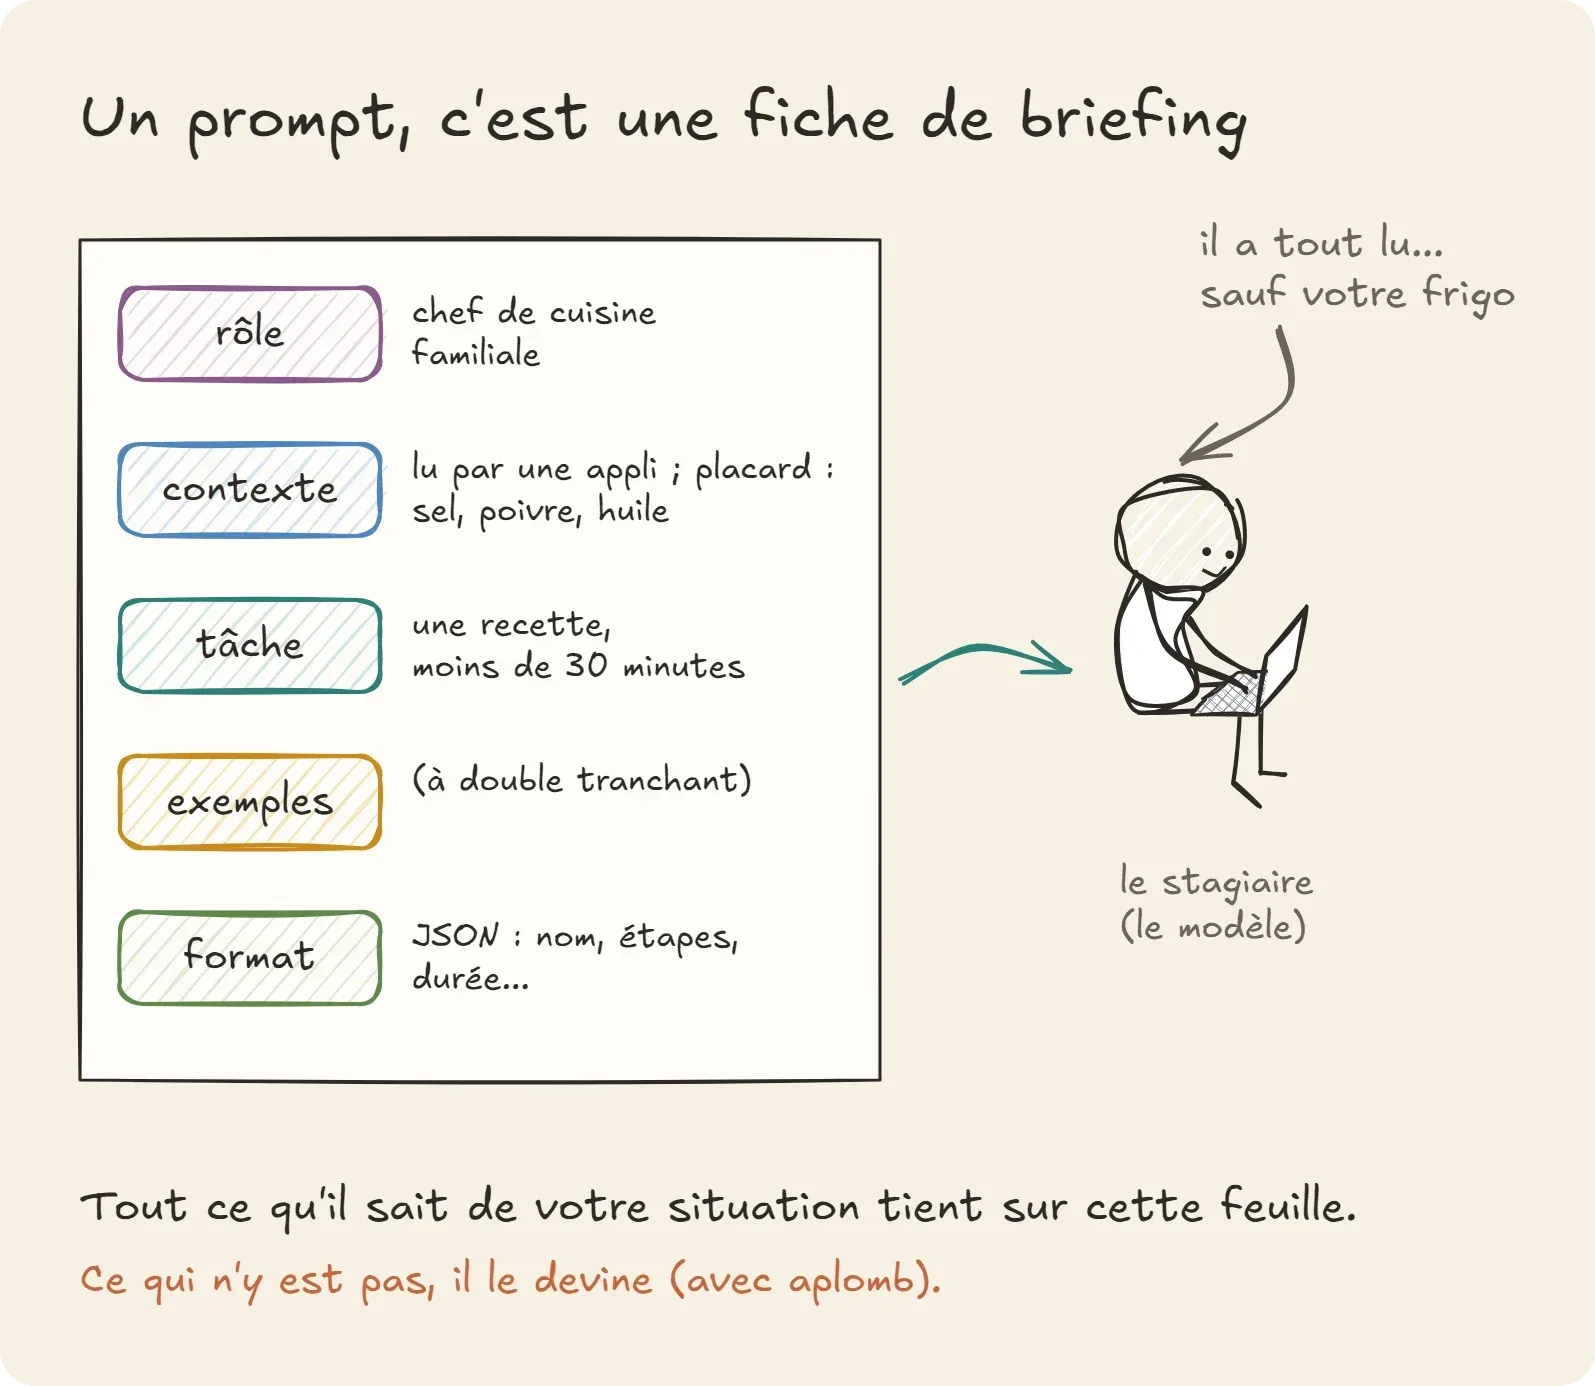
J'y ajoute un détail : ce stagiaire est amnésique. Il a lu une bibliothèque entière pendant sa formation (c'est l'entraînement du modèle), il écrit vite et bien. Mais chaque demande est son premier jour. Il ne connaît ni votre frigo, ni votre placard, ni la recette qu'il vous a proposée hier. Tout ce qu'il sait de votre situation tient sur la feuille que vous posez sur son bureau.
Cette image règle déjà la moitié des problèmes. Quand une réponse est à côté de la plaque, la bonne question n'est pas « pourquoi l'IA est bête ? », mais « qu'est-ce qui manquait sur la feuille ? ». Ce qui n'est pas écrit, le stagiaire le devine. Et il devine avec beaucoup d'aplomb.
Étape 1 : la question toute bête
Première version de Frigo Chef, la plus naturelle : on pose la question comme à un ami. « Dans mon frigo : trois œufs, un demi-poivron rouge… Qu'est-ce que je peux cuisiner ce soir ? »
Les trois modèles ont répondu très bien… pour un humain. Un riz sauté, à chaque fois, présenté avec des titres, du gras et des listes à puces : entre 297 et 498 mots selon le modèle. Pour un programme, c'est inutilisable. Où commence le nom de la recette ? Où sont les étapes ? Le code ne peut pas deviner.
Et il y a plus discret. Les trois modèles ont ajouté de l'huile, et deux d'entre eux du poivre. Je ne leur avais pas parlé de mon placard : ils ont deviné. L'un d'eux proposait même « éventuellement ail ou oignon si tu en as aussi ». Rien de grave ici, mais c'est le stagiaire en action : ce qui n'est pas sur la feuille, il le complète, sans rien dire.
Étape 2 : la fiche de briefing
Un prompt, ce n'est pas forcément une seule phrase. Dans une appli, il y a souvent deux parties :
- le prompt système : les consignes permanentes, écrites une fois par le développeur. Pour Frigo Chef, c'est le rôle du chef et la forme de la fiche recette.
- le message utilisateur : la demande du moment. Ici, le contenu du frigo.
Dans ChatGPT ou Claude en ligne, le prompt système existe aussi, mais c'est l'éditeur qui l'écrit et vous ne le voyez pas. Vous l'écrivez vous-même quand vous passez par une API : la porte d'entrée par laquelle un programme envoie ses demandes au modèle et reçoit les réponses.
Le prompt système, c'est la fiche de poste. Le message utilisateur, c'est le dossier du jour. Une bonne fiche contient, dans un ordre ou un autre, cinq rubriques :
- Le rôle : qui est le stagiaire pour cette tâche. « Tu es un chef de cuisine familiale. » Une seule phrase suffit à changer le ton, d'après la documentation de Claude.
- Le contexte, avec le pourquoi : à qui s'adresse la réponse, à quoi elle va servir. Le pourquoi compte plus qu'on ne croit. L'exemple d'Anthropic est parlant : au lieu de « N'utilise JAMAIS de points de suspension », écrivez que la réponse sera lue par une synthèse vocale, qui ne sait pas les prononcer. Le modèle généralise à partir de l'explication et évitera aussi d'autres pièges que vous n'aviez pas listés.
- La tâche : ce qu'on veut, précisément, avec les étapes dans l'ordre si l'ordre compte.
- Des exemples : à quoi ressemble une bonne réponse (on en reparle, c'est à double tranchant).
- Le format : la forme exacte de la réponse. Longueur, langue, liste ou paragraphe, champs à remplir.
Séparer les rubriques
Pour que le stagiaire distingue les rubriques, séparez-les. Des titres, des lignes vides, ou des balises comme <contexte> et <format> font très bien l'affaire. Anthropic recommande les balises de ce genre quand un prompt mélange consignes, contexte, exemples et données, pour éviter les malentendus : sans elles, le modèle peut prendre un bout de vos données pour une consigne.
Voici la fiche de Frigo Chef, à peine abrégée par rapport à celle que j'ai testée :
<role>
Tu es un chef de cuisine familiale, pratique et un peu taquin.
</role>
<contexte>
Ta réponse est lue par une appli, pas par une personne : elle passe
directement dans JSON.parse(), puis s'affiche sous forme de fiche recette.
La personne n'a que ce qui est dans son frigo, plus ce placard :
sel, poivre, huile d'olive. Rien d'autre.
</contexte>
<tache>
Propose une seule recette faisable ce soir, en moins de 30 minutes,
avec ces ingrédients uniquement.
</tache>
<format>
Commence ta réponse par { et termine-la par }.
Champs : nom (texte), ingredients_utilises (liste), ingredients_manquants
(liste, vide si rien ne manque), etapes (liste), duree_minutes (entier).
</format>
Le JSON, c'est un format de données bien rangé que le code sait lire, et JSON.parse() la fonction qui le lit. Vous remarquerez deux choses. La consigne de format est positive : « commence par { », plutôt que « pas de Markdown » (le Markdown, c'est la syntaxe à dièses et astérisques que les chats utilisent pour mettre leurs réponses en forme). La documentation de Claude conseille justement de dire ce qu'il faut faire plutôt que ce qu'il ne faut pas faire. Et le contexte donne le pourquoi : la réponse est lue par un programme.
Ce que change une ligne de contexte
Pour mesurer l'effet de la fiche, j'ai comparé trois prompts système, cinq fois chacun sur chaque modèle. Le premier se contente de demander du JSON avec les bons champs. Le deuxième est le même, plus une seule ligne : « La personne n'a que ce qui est dans son frigo, plus ce placard : sel, poivre, huile d'olive. Rien d'autre. » Le troisième est la fiche complète ci-dessus.
Avec la demande courte, 9 fiches sur 15 listaient des ingrédients « manquants » : de l'huile, du beurre, « ail ou oignon (facultatif) ». Trois fois, une étape proposait même de cuire à l'huile ou au beurre : je n'ai pas de beurre. Avec la ligne du placard en plus, 0 sur 15, et plus aucun beurre. Avec la fiche complète, 0 sur 15 aussi. Ici, toute la différence tenait en une ligne : le stagiaire n'avait plus rien à deviner.
C'est la règle d'or de la même documentation, que je trouve imparable : montrez votre prompt à un collègue qui ne connaît pas le sujet. S'il vous demande « et dans le placard, il y a quoi ? », le modèle se posait la même question. Lui, simplement, ne la pose pas : il répond quand même.
Les grands types de prompts
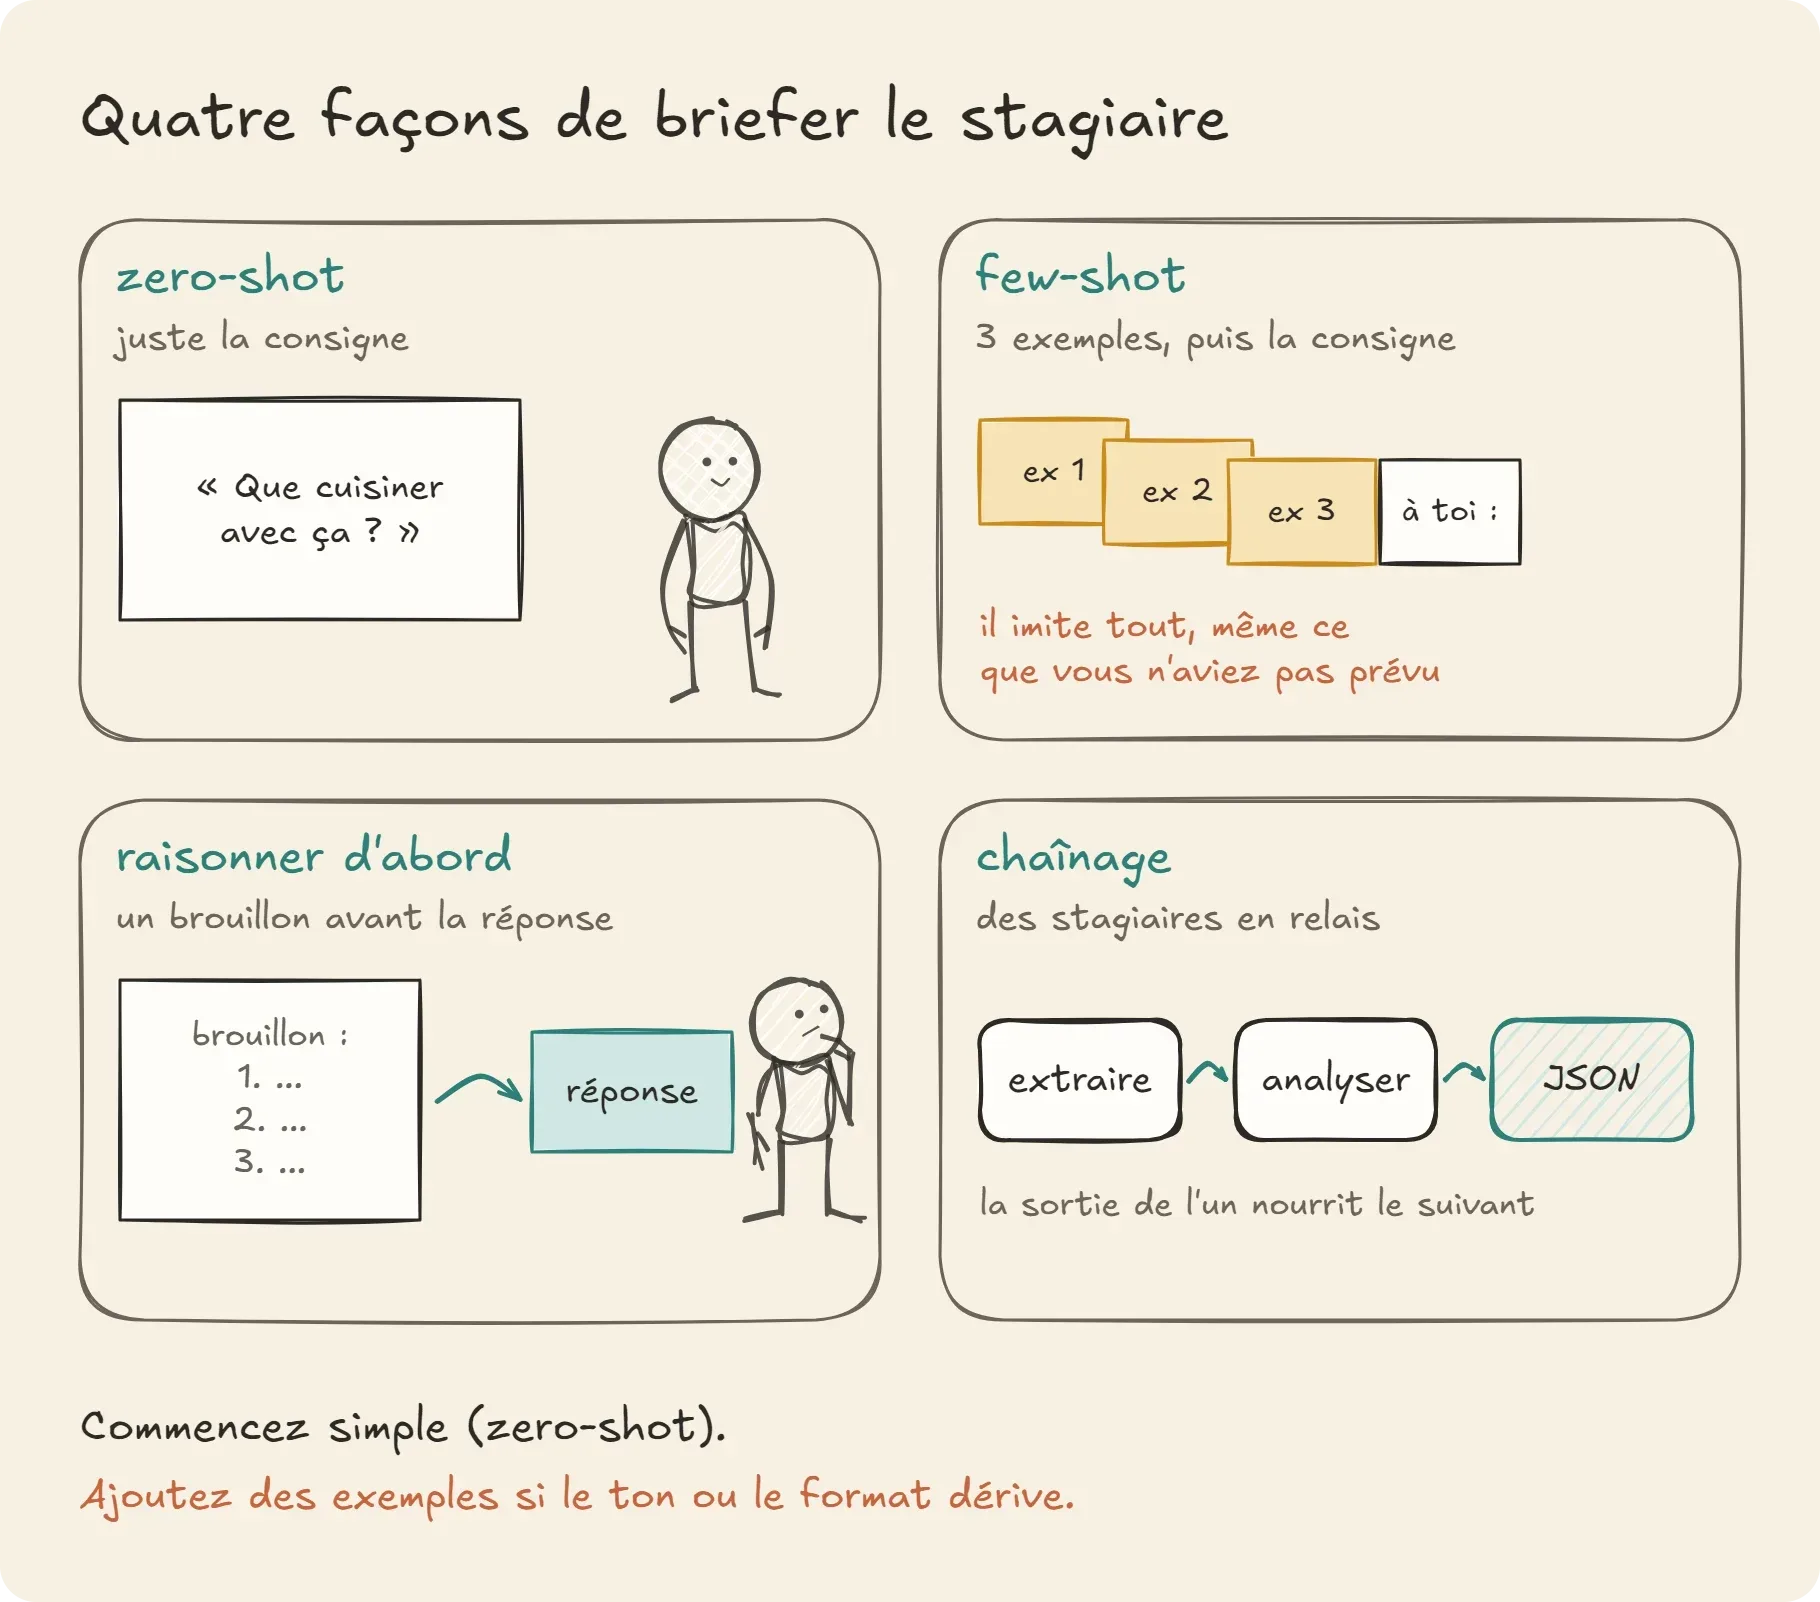
On lit beaucoup de noms savants. En réalité, il y a quatre grandes façons de briefer le stagiaire, et une poignée de variantes.
Type | Ce que c'est | Quand l'utiliser | Pour creuser |
|---|---|---|---|
Zero-shot | Juste la consigne, sans exemple. C'est ce que fait la fiche de Frigo Chef. | Les tâches simples et courantes : résumer, traduire, classer, proposer une recette. Commencez toujours par là. | |
Few-shot | Quelques exemples de questions et de bonnes réponses avant la vraie question. | Quand le ton ou le format doit être très précis. | |
Raisonner d'abord (chain of thought) | Demander au modèle de détailler son raisonnement avant de conclure. | Calculs, logique, problèmes en plusieurs étapes. | |
Chaînage | Découper une grosse tâche en plusieurs prompts, la sortie de l'un nourrissant le suivant. | Les tâches longues. Pour Frigo Chef : un prompt qui lit une photo du frigo, puis un autre qui écrit la recette. |
Le rôle (« tu es un chef », « tu es un juriste ») se combine avec les quatre. Et quand on donne au modèle des documents à lire avant de répondre (votre carnet de recettes, vos fiches produits), on parle de RAG, pour Retrieval-Augmented Generation : on va chercher les bonnes pages, on les pose sur le bureau, puis on pose la question.
Raisonner d'abord : le brouillon avant la copie
En 2022, une équipe de Google a montré qu'en donnant au modèle quelques exemples de raisonnement pas à pas, on améliorait nettement ses résultats sur des problèmes de maths (Wei et al., Chain-of-Thought Prompting). Depuis, beaucoup de modèles le font tout seuls : ce sont les modèles dits de raisonnement, qui « réfléchissent » avant de répondre. C'est très utile pour un problème difficile. Pour un riz sauté, c'est une autre histoire, et une affaire de budget, comme on va le voir avec les tokens.
Étape 3 : les exemples, ou l'art d'être copié
Les fiches de Frigo Chef étaient justes, mais tristes : « Riz sauté aux œufs, poivron et comté », cinq fois de suite. Je voulais des noms drôles. J'ai donc ajouté au prompt : « Donne à la recette un nom drôle. Sois original. Par exemple : "Le riz qui a eu une deuxième chance", "L'omelette du lundi soir", "Le gratin de la dernière chance". »
Résultat, sur 15 fiches : une reprend mon exemple mot pour mot (« Le riz qui a eu une deuxième chance »), d'autres le décalquent à peine (« Le riz de la seconde chance… », « Le riz de la dernière cuillère »), et Claude Haiku m'a servi trois fois le même nom sur cinq essais. « Sois original », suivi de trois réponses toutes faites : le stagiaire a choisi les réponses toutes faites. On ne peut pas lui en vouloir, c'est ce qu'on lui a montré.
Remplacer les exemples par une description
J'ai alors remplacé les exemples par une description : « une courte phrase qui raconte l'histoire des restes, jamais une formule déjà utilisée dans ce message ». Les noms sont devenus plus inventifs (« Le riz d'hier pardonne le citron fatigué », c'est de Qwen). Mais chaque modèle a vite trouvé son tic : quatre fois sur cinq, et la cinquième à un mot près, le nom de Claude Haiku commençait par « Le riz d'hier refuse de finir à la poubelle ». Le mot « poubelle » n'était nulle part dans mon prompt.
La documentation de Claude conseille des exemples pertinents, variés, et clairement séparés des consignes, au nombre de trois à cinq. Variés, c'est le mot clé : avec un seul style d'exemple, le modèle copie ce style, y compris les détails que vous n'aviez pas remarqués (la longueur, la structure, le premier mot). Pour de l'invention, décrivez la recette plutôt que de donner le plat. Et pour de la vraie variété, il faudra un autre outil : on y vient avec la température.
Étape 4 : obtenir un format précis, demander, montrer, mouler
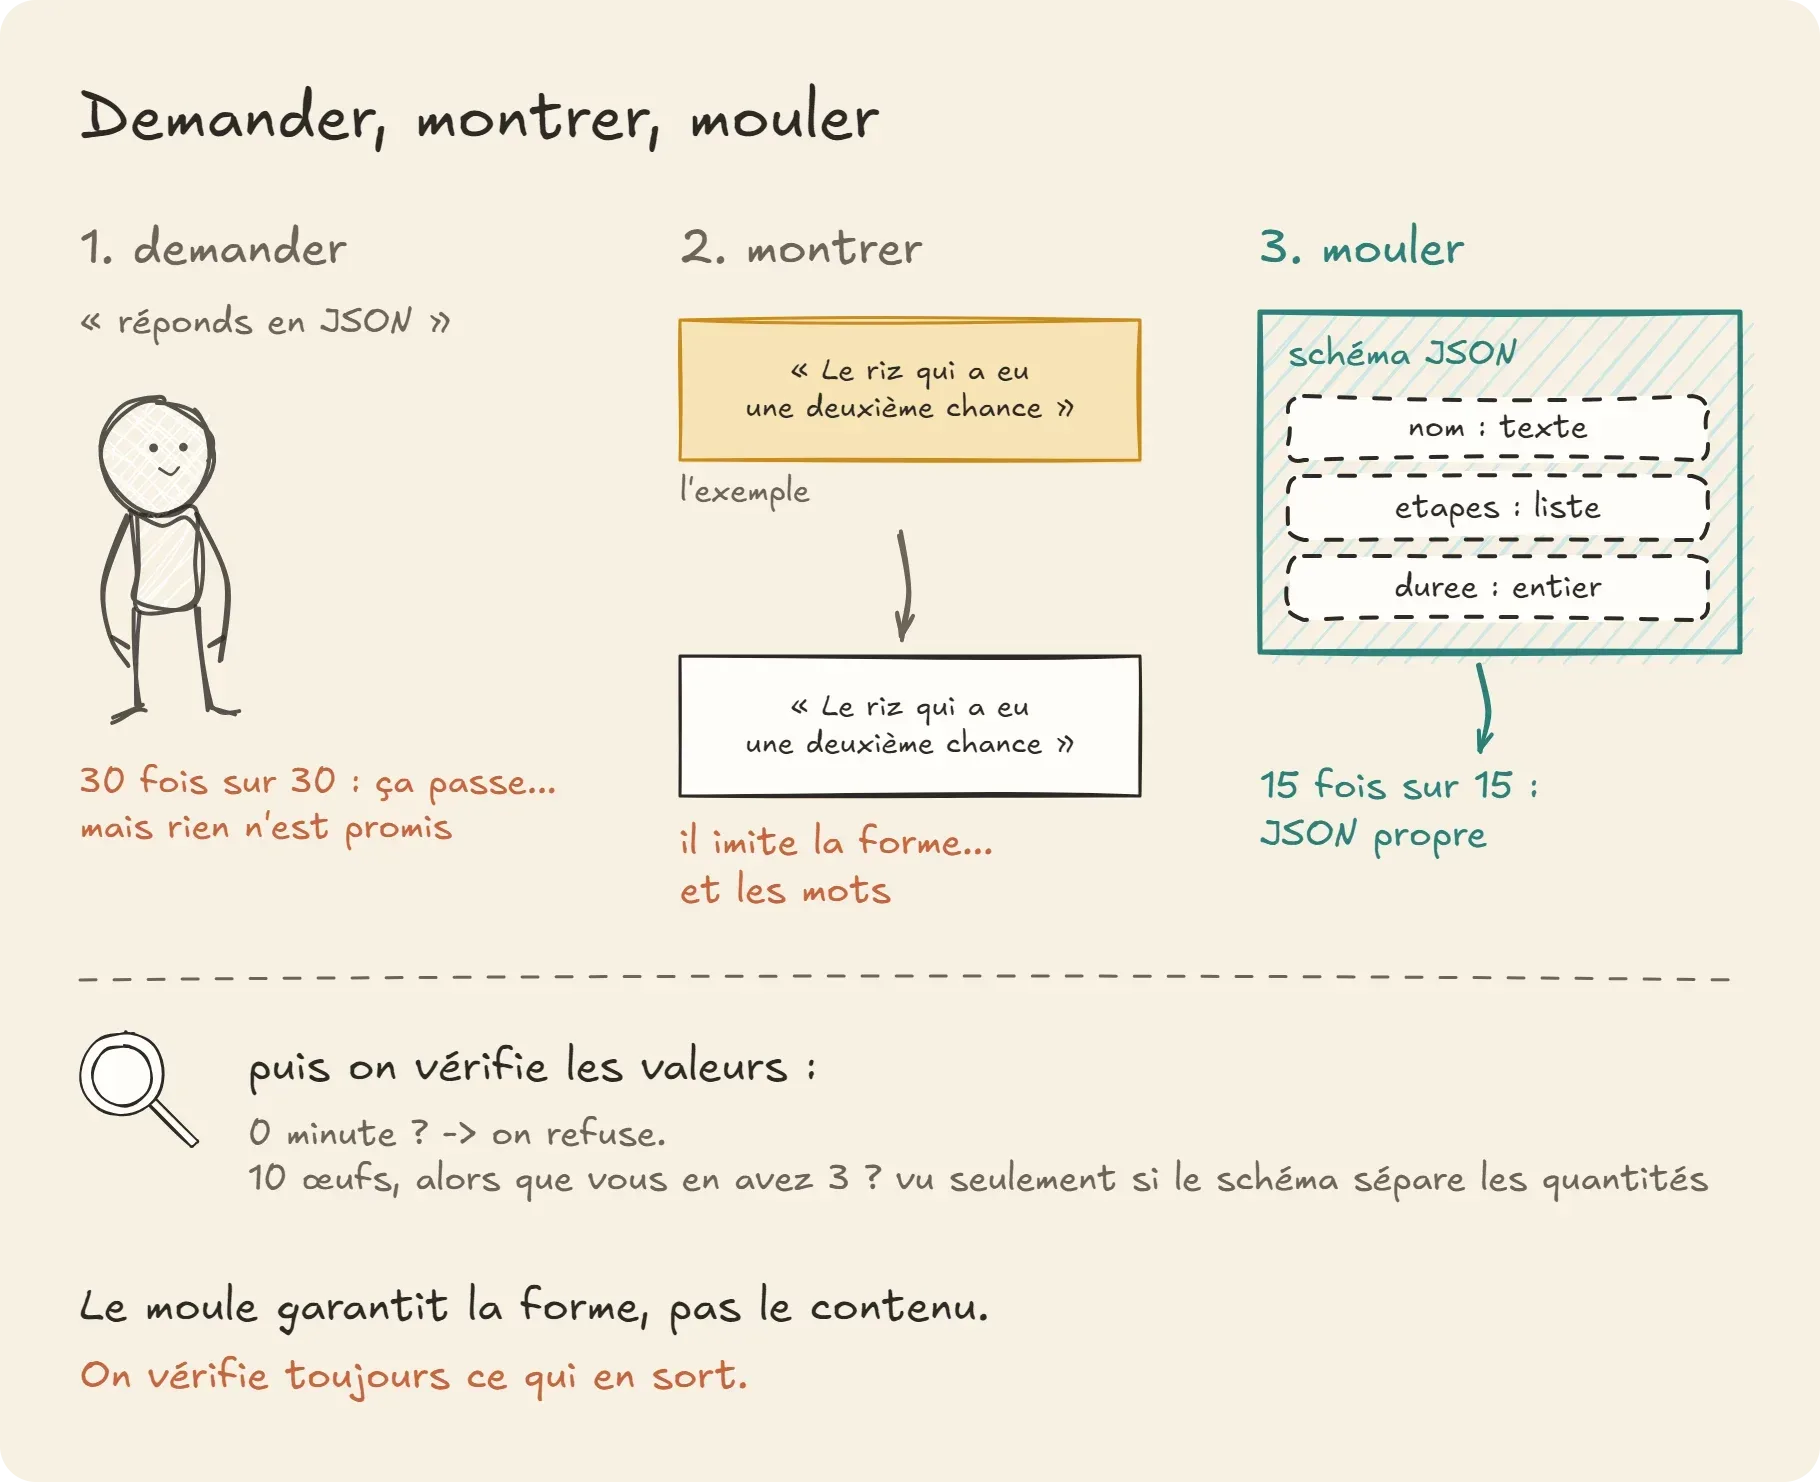
C'est le cœur de Frigo Chef : l'appli doit recevoir exactement la forme de réponse que son code sait lire. Il y a trois niveaux, du plus poli au plus ferme.
1. Demander
C'est ce que font mes prompts système : ils demandent du JSON, poliment. Et en octobre 2026, ça marche plutôt bien. Sur mes 30 appels avec la demande courte et la fiche complète, les trois modèles ont renvoyé 30 fois du JSON lisible tel quel, sans emballage.
Mais demander, c'est une promesse, pas une garantie. Rien n'empêche le modèle d'oublier un champ, d'en inventer un, d'écrire "vingt" au lieu de 20, ou d'emballer sa réponse dans du Markdown le jour où vous changez de modèle. Chez OpenAI, la documentation le dit clairement : même le « mode JSON » garantit seulement du JSON valide, et seuls les Structured Outputs garantissent le respect du schéma. Pour un programme qui tourne seul la nuit, « plutôt bien », ce n'est pas assez.
2. Montrer
Donner un exemple complet de réponse attendue. Le modèle imite la forme (et, on l'a vu à l'étape 3, les mots). Utile pour un format de texte, un ton, une structure de rapport.
3. Mouler
La plupart des API récentes acceptent un schéma JSON : une description de la forme attendue (tel champ est un texte, tel autre un nombre entier, celui-ci est obligatoire). Le modèle ne peut alors produire que des réponses qui rentrent dans le moule. Google, Anthropic et OpenRouter proposent l'équivalent des Structured Outputs d'OpenAI (Gemini, Claude, OpenRouter).
Pour Frigo Chef, le moule tient en quelques lignes ajoutées à la demande envoyée à OpenRouter :
response_format: {
  type: "json_schema",
  json_schema: {
    name: "recette",
    strict: true,
    schema: {
      type: "object",
      properties: {
        nom: { type: "string" },
        ingredients_utilises: { type: "array", items: { type: "string" } },
        ingredients_manquants: { type: "array", items: { type: "string" } },
        etapes: { type: "array", items: { type: "string" } },
        duree_minutes: { type: "integer" },
      },
      required: ["nom", "ingredients_utilises", "ingredients_manquants",
                 "etapes", "duree_minutes"],
      additionalProperties: false,
    },
  },
},
Avec le moule, 15 réponses sur 15 sont arrivées avec exactement ces cinq champs, du bon type. Le schéma est resté en place pour les essais sur les noms, la mémoire et la température.
Et après le moule, on vérifie
Le moule garantit la forme, pas le contenu. Google le dit lui-même : la réponse est du JSON syntaxiquement correct, mais il faut toujours valider les valeurs dans votre application, et la même page prévient que certaines contraintes du schéma (longueur minimale ou maximale d'un texte, par exemple) sont ignorées par le serveur.
Frigo Chef m'en a donné deux exemples parfaits, que vous retrouverez à l'étape suivante. Une fiche intitulée « Recette en attente », avec une durée de 0 minute et zéro ingrédient. Et une omelette pour quatre avec 10 œufs, alors que le frigo en contient trois, et une liste d'ingrédients manquants… vide. Les deux rentraient parfaitement dans le moule.
Alors après le moule, quelques lignes de code vérifient ce qui en sort :
function verifierRecette(r) {
  if (r.etapes.length === 0) return "pas d'étapes";
  if (r.duree_minutes < 1 || r.duree_minutes > 30) return "durée hors limites";
  if (r.ingredients_manquants.length > 0) return "il manque des ingrédients";
  return null; // tout va bien
}
Cette vérification attrape la recette en attente. Les 10 œufs, non : « 10 œufs » est un texte, et le code ne sait pas le comparer à mes trois œufs. Leçon utile : un schéma bien pensé rend le contenu vérifiable. Si je veux contrôler les quantités, le moule doit les séparer, par exemple { "ingredient": "œufs", "quantite": 10 }, pour que le code puisse comparer 10 à 3.
Étape 5 : la mémoire, il n'y en a pas
Frigo Chef propose un riz sauté. Je réponds : « Finalement, sans le poivron, et pour 4 personnes. » Une conversation tout à fait normale. Sauf que le modèle, lui, n'a aucune mémoire entre deux appels.
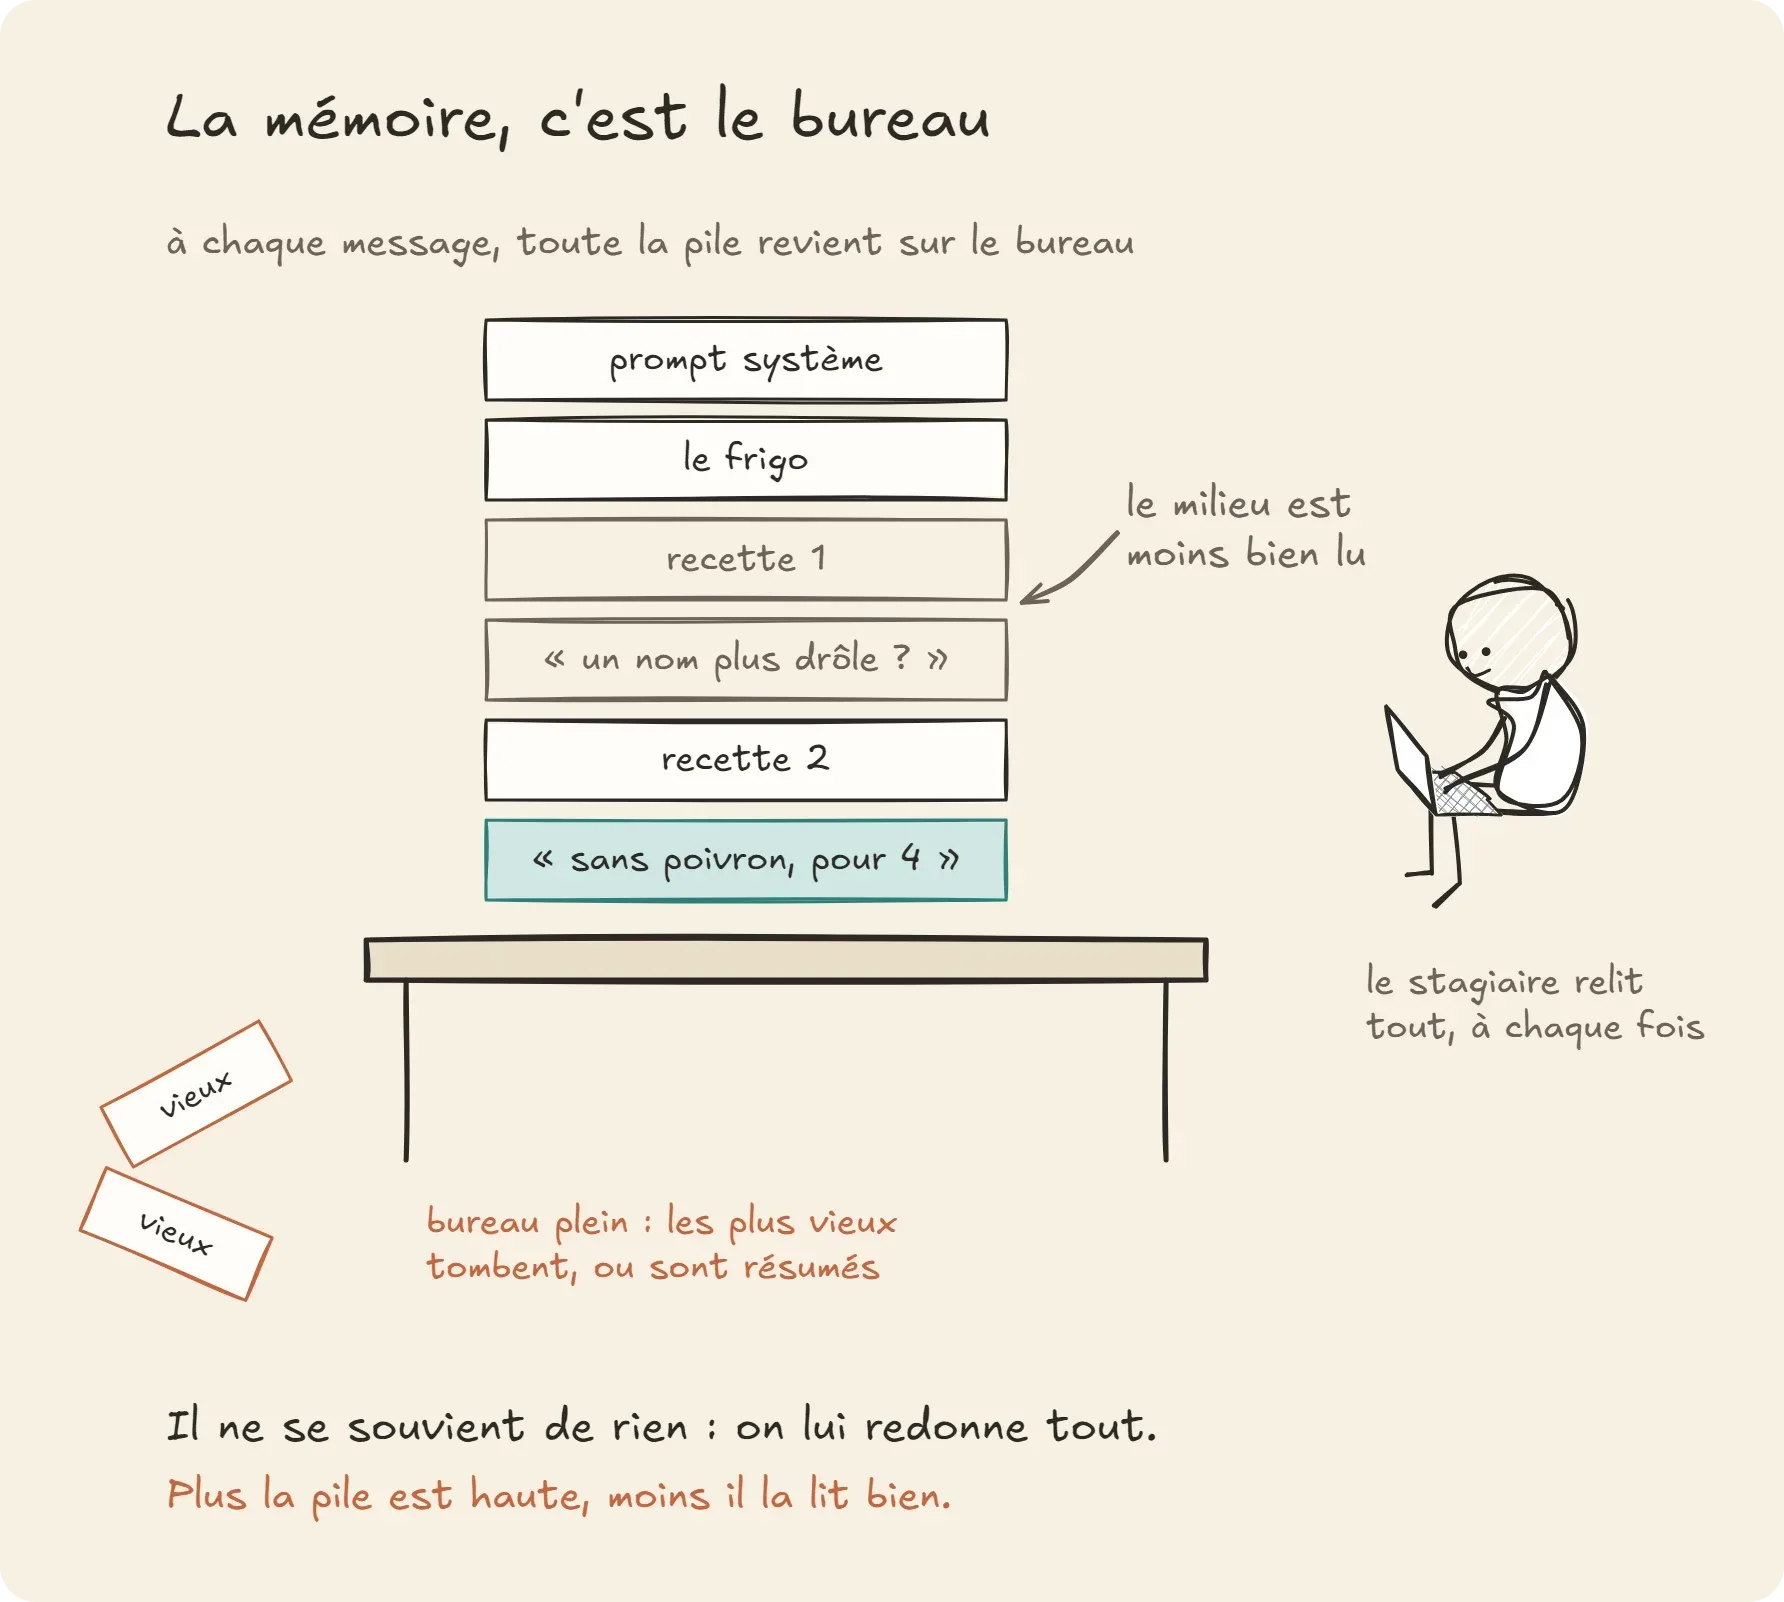
Quand vous discutez avec ChatGPT, vous avez l'impression qu'il se souvient de ce que vous avez dit trois messages plus tôt. En réalité, à chaque nouveau message, l'application lui renvoie toute la conversation depuis le début. Le modèle relit tout, à chaque fois, comme notre stagiaire qui retrouverait chaque matin sur son bureau la pile complète des échanges de la veille.
Avec ou sans historique
J'ai fait les deux essais, sur chaque modèle :
- avec l'historique (le frigo, la première recette, puis ma demande) : les trois ont adapté le riz sauté. Claude Haiku a même noté qu'il manquait deux œufs et environ trois bols de riz pour nourrir quatre personnes ;
- sans l'historique (juste « sans le poivron, et pour 4 personnes ») : Claude Haiku a renvoyé la fameuse « Recette en attente » en demandant la liste du frigo. Gemini a inventé une « Poêlée de légumes rustique » avec « les légumes que vous avez trouvés au fond du frigo ». Et Qwen a cassé 10 œufs pour une omelette.
Un seul des trois a dit « je ne sais pas ». Les deux autres ont deviné, avec aplomb.
Cette pile de messages a un nom : la fenêtre de contexte. Anthropic la décrit comme la « mémoire de travail » du modèle, à ne pas confondre avec tout ce qu'il a appris à l'entraînement. Tout y compte : le prompt système, chaque message, les documents joints, et la réponse en cours d'écriture.
Trois conséquences pratiques
- Une longue conversation coûte de plus en plus cher. Chaque message renvoie toute la pile, donc on repaie la lecture de tout l'historique.
- Plus la pile est haute, moins il lit bien. Anthropic appelle ça le context rot : quand le nombre de tokens augmente, la précision et le rappel se dégradent. Des chercheurs de Stanford et de Berkeley ont montré un effet très concret : les modèles retrouvent mieux une information placée au début ou à la fin d'un long texte qu'au milieu (Liu et al., 2023). Le milieu de la pile, c'est le fond du tiroir.
- Quand le bureau est plein, quelque chose tombe. Selon l'application, les vieux messages sont oubliés ou résumés. Ce que vous aviez précisé au début peut disparaître sans prévenir.
Ce que j'en retiens au quotidien : pour un nouveau sujet, ouvrez une nouvelle conversation. Mettez les documents longs en haut et la question à la fin : Anthropic rapporte jusqu'à 30 % de qualité en plus dans ses tests avec la question à la fin, sur des entrées longues. Et quand une conversation part en vrille, demandez un résumé, puis recommencez au propre avec ce résumé. Les fonctions « mémoire » des applications grand public ne changent pas le principe : elles prennent des notes, et posent ces notes sur le bureau au début de la conversation suivante.
Étape 6 : les tokens, la petite monnaie de l'IA
Un modèle ne lit pas des mots ni des lettres, mais des tokens : des morceaux de texte, souvent un mot court ou un bout de mot long. « Bonjour » peut faire un token, « anticonstitutionnellement » en fait plusieurs. Tout se compte en tokens :
- le prix : les API facturent les tokens lus (l'entrée) et les tokens écrits (la sortie), la sortie coûtant en général plus cher ;
- la taille du bureau : la fenêtre de contexte se mesure en tokens ;
- la longueur de la réponse : on la plafonne en tokens, avec le paramètre
max_tokens.
Pour voir à quoi ressemblent des tokens, collez une phrase dans Tiktokenizer : chaque morceau s'affiche en couleur.
Le même texte n'a pas le même prix partout
Le découpage dépend du modèle. J'ai envoyé la même consigne courte de Frigo Chef en français et en anglais aux trois modèles, et lu le compte dans leur réponse :
Modèle | Consigne en anglais | La même en français | La fiche complète |
|---|---|---|---|
Gemini 3.1 Flash Lite | 47 tokens | 59 tokens | 203 tokens |
Qwen 3.8 Flash | 105 tokens | 116 tokens | 257 tokens |
Claude Haiku 5.5 | 81 tokens | 108 tokens | 313 tokens |
Ces comptes incluent les quelques tokens que chaque fournisseur ajoute autour d'un message, d'où les écarts entre modèles. Deux leçons. Le français coûte ici de 10 à 33 % de tokens en plus que l'anglais, pour dire la même chose. Et le même texte ne pèse pas pareil d'un modèle à l'autre : ne comparez jamais des prix « au token » sans recompter. Les API donnent le vrai compte dans chaque réponse (le champ usage chez OpenAI, Anthropic et OpenRouter, usageMetadata chez Gemini) : c'est lui qu'il faut lire, pas une estimation faite à la main.
La réflexion se paie aussi, et sur le même budget
Les modèles de raisonnement « réfléchissent » avant de répondre, et cette réflexion est faite de tokens. Chez Google comme chez OpenRouter, ces tokens de réflexion sont facturés comme de la sortie, et le plafond de longueur les inclut.
Une fiche de Frigo Chef fait environ 300 tokens. J'ai donc plafonné la réponse à 400, avec la réflexion réglée au maximum (effort élevé) :
- Gemini a réfléchi pendant 380 tokens. La fiche s'est arrêtée net après le nom de la recette :
{ "nom": "Riz sauté 'vide-frigo'. Raison de l'arrêt :MAX_TOKENS, plafond atteint ; - Qwen a réfléchi pendant 400 tokens sur 400. Réponse : rien. Pas un caractère ;
- Claude Haiku, coupé aussi, en pleine liste d'ingrédients.
Combien ça coûte
OpenRouter décrit exactement ce piège : si la réflexion consomme tout le budget, la réponse revient vide, et vous êtes quand même facturé. Avec la réflexion coupée, Gemini et Qwen ont rendu une fiche complète en un peu plus de 300 tokens (Claude Haiku, plus bavard, dépassait les 400 même sans réfléchir). Avec la réflexion au maximum et un plafond de 4 000, les trois ont rendu une fiche complète, mais en dépensant de 1 341 à 1 477 tokens : plus de quatre fois le prix, pour un riz sauté. Pour une tâche simple, coupez ou baissez la réflexion. Pour une tâche difficile, laissez-la, mais donnez un plafond bien plus haut que la réponse attendue.
Tous les modèles ne se valent pas (et ils prennent leur retraite)
Sur la liste des modèles d'OpenRouter, un service qui donne accès à des centaines de modèles avec une seule clé, on peut comparer leurs caractéristiques côte à côte. Celles qui comptent pour un prompt :
Ce qui change | Ce que ça veut dire pour vous |
|---|---|
La taille et le prix | Les « petits » modèles (flash, mini, haiku, lite) sont rapides et pas chers, parfaits pour classer, reformuler ou proposer un riz sauté. Les gros raisonnent mieux sur les tâches difficiles, plus lentement et plus cher. |
Le raisonnement | Certains réfléchissent avant de répondre, parfois par défaut. Plus fiables sur la logique, plus de tokens, plus de latence. |
La fenêtre de contexte | La taille du bureau : de quelques dizaines de milliers à un ou deux millions de tokens selon les modèles. |
La date de connaissance | Ce que le modèle a lu s'arrête à une date. Après, il ne sait pas, sauf si vous le lui dites (ou s'il peut chercher sur le web). |
Le caractère | Chaque famille suit les consignes à sa façon. Un prompt réglé pour un modèle n'est pas garanti sur un autre. |
Les fonctions et réglages acceptés | Schéma JSON, outils, images, paramètres : tous ne gèrent pas tout. |
Trois cuisiniers, trois caractères
Frigo Chef a eu trois cuisiniers, choisis parmi les petits modèles bon marché d'OpenRouter. Sur les mêmes prompts, ils ne se ressemblent pas :
Gemini 3.1 Flash Lite | Claude Haiku 5.5 | Qwen 3.8 Flash | |
|---|---|---|---|
Prix (entrée / sortie, par million de tokens) | 0,25 $ / 1,50 $ | 0,10 $ / 0,50 $ | 0,15 $ / 0,47 $ |
Tokens de sortie par fiche, réflexion comprise (consigne courte) | 224 à 273 | 614 à 711 | 433 à 1 354 |
Réflexion par défaut | aucune | de 171 à 251 tokens | de 164 à 963 tokens |
Accepte le réglage | oui | non | oui |
Sans l'historique | invente une poêlée | demande la liste du frigo | casse 10 œufs |
Le moins cher au million de tokens n'est pas forcément le moins cher par fiche. Avec la consigne courte, une fiche m'a coûté de 0,037 à 0,044 centime de dollar chez Gemini, de 0,033 à 0,038 chez Claude Haiku (deux fois et demie plus long, mais moins cher au token), et de 0,023 à 0,066 chez Qwen, selon la longueur de sa réflexion. Et le seul qui a réclamé la liste du frigo au lieu de l'inventer est aussi celui qui ignore la température. Chaque cuisinier a ses qualités et ses tics. D'où la règle : quand vous changez de modèle, retestez vos prompts. Un bon prompt est écrit pour un stagiaire précis.
Les modèles prennent leur retraite
Et surtout, les modèles meurent. Les fournisseurs les arrêtent régulièrement : Google, par exemple, a arrêté gemini-2.0-flash et gemini-2.0-flash-lite le 1er juin 2026. Une appli qui appelle un modèle arrêté reçoit une erreur, du jour au lendemain. Moralité : notez quel modèle vous utilisez, surveillez sa date de retraite, et prévoyez un modèle de secours que vous avez vraiment testé avec vos prompts.
Étape 7 : les paramètres, curseur par curseur
En plus du texte, on envoie au modèle quelques réglages. OpenRouter en tient une liste commune à tous ses modèles, c'est la référence la plus pratique. Dans ChatGPT ou Claude en ligne, ces curseurs sont cachés : ils concernent ceux qui passent par une API ou par OpenRouter. Voici ceux que vous croiserez, traduits en français courant.
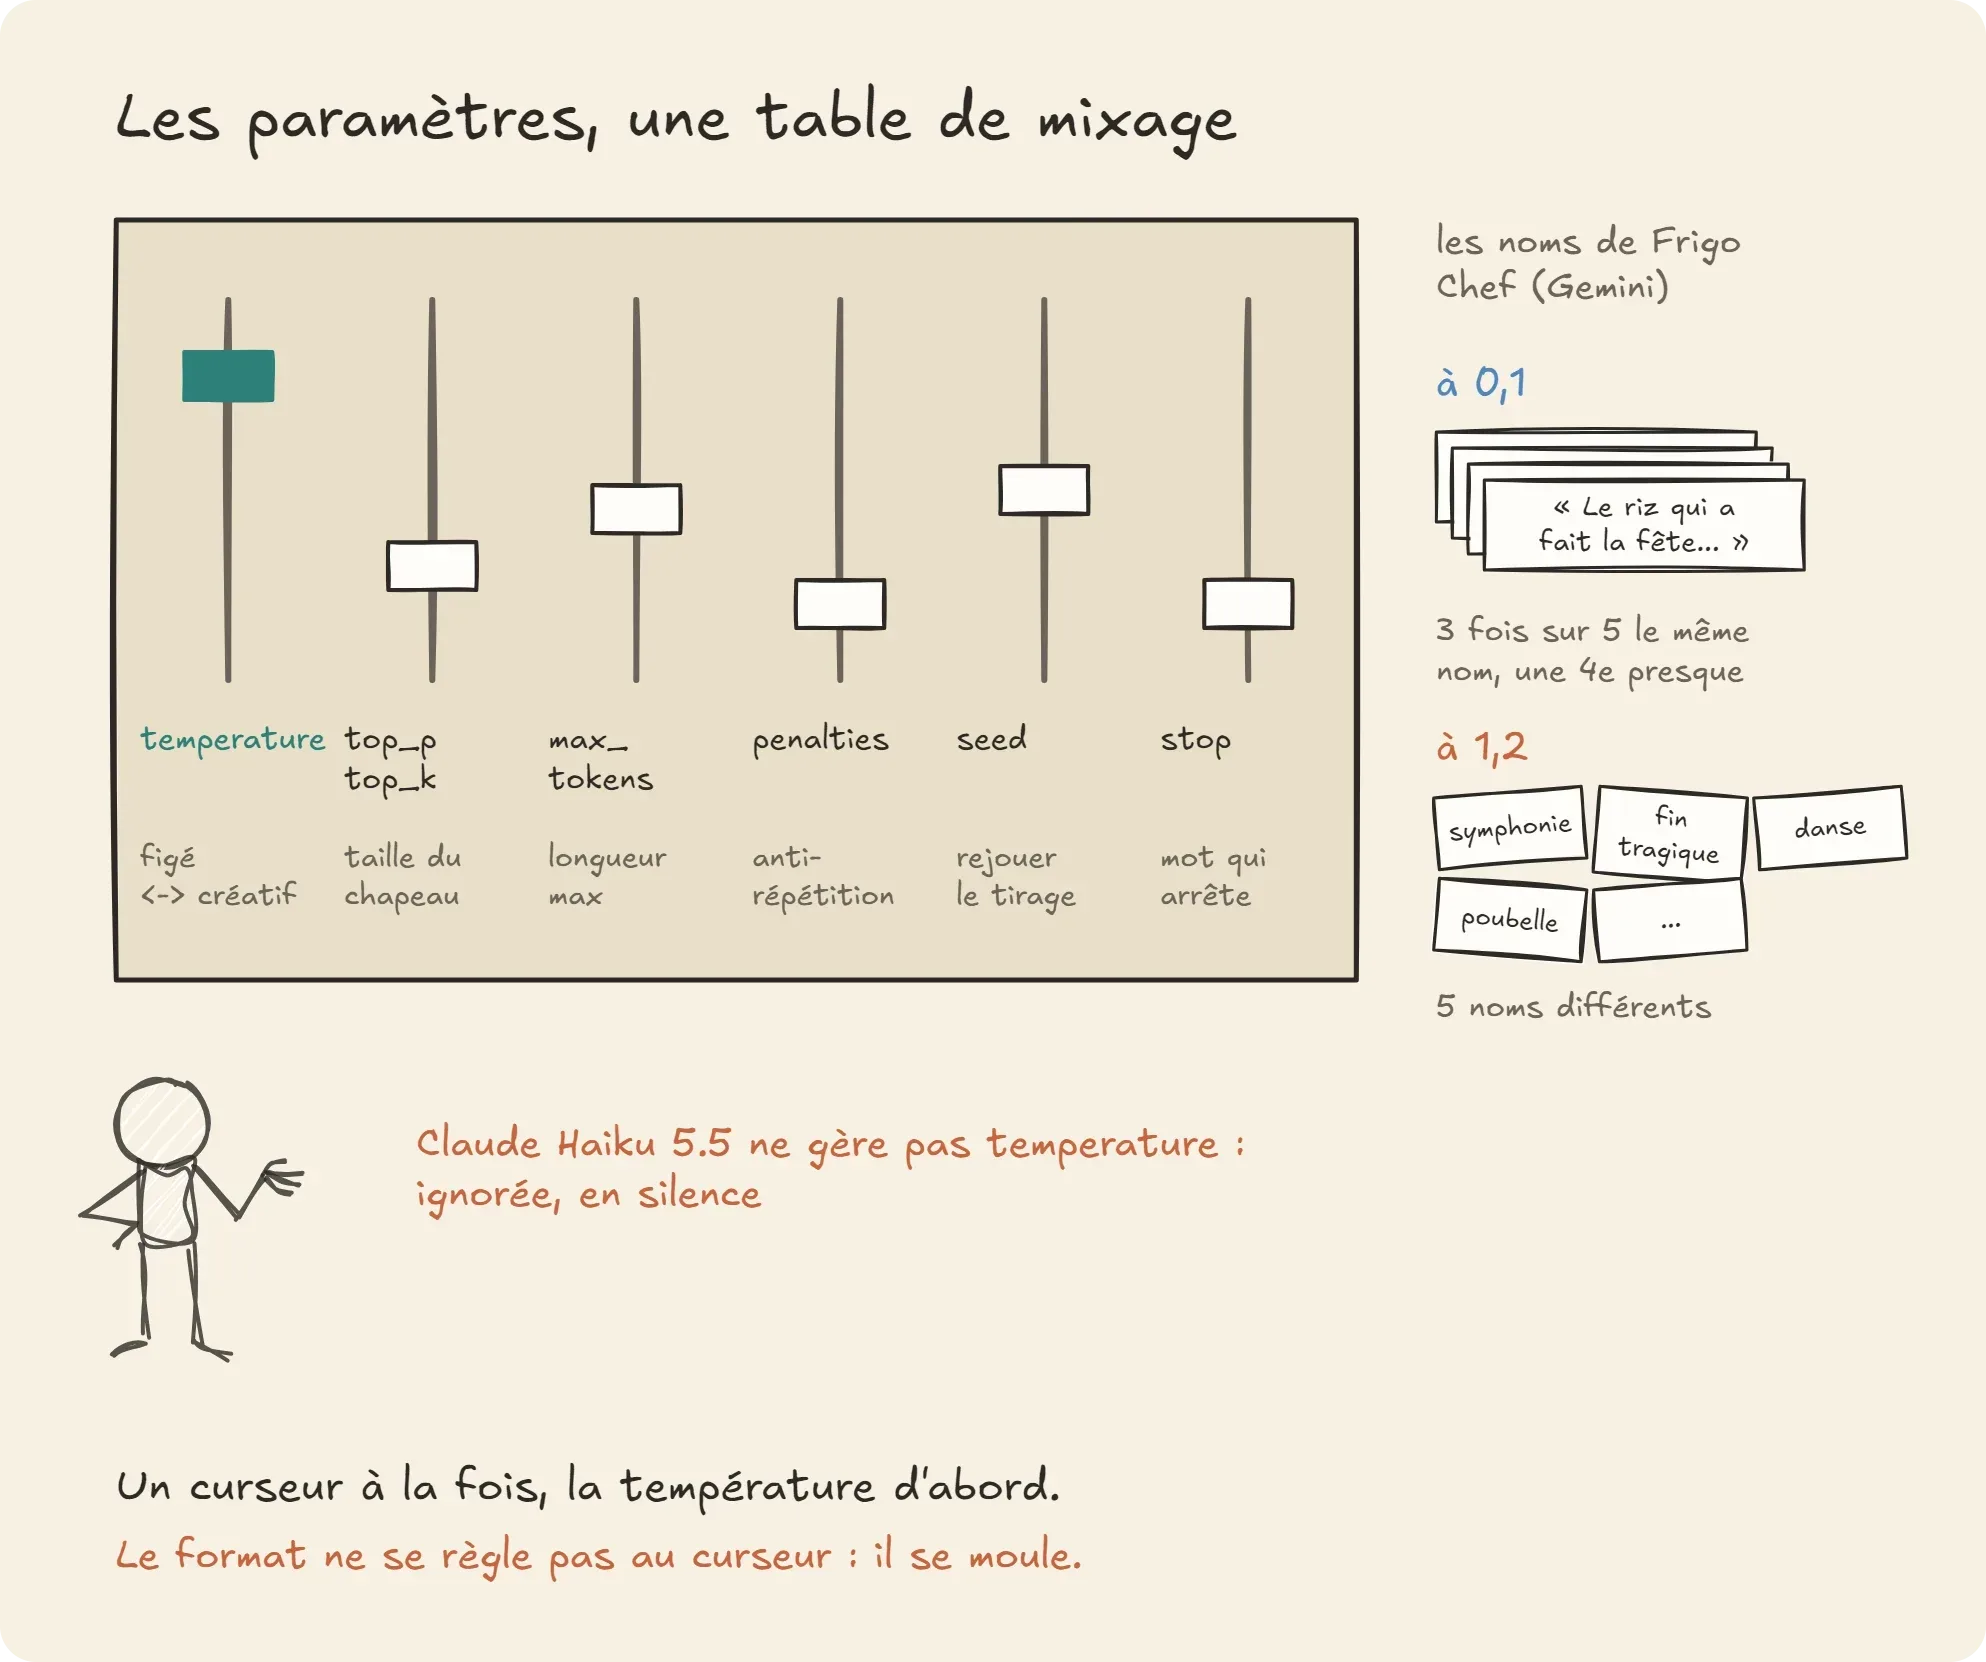
Paramètre | Ce qu'il règle | Mon conseil |
|---|---|---|
| Le hasard. Bas : la réponse la plus probable, quasi identique à chaque fois. Haut : plus de variété, plus de dérapages. De 0 à 2 chez OpenRouter, 1 par défaut. | Bas (0 à 0,3) pour extraire, classer, produire des données. Plus haut pour écrire, inventer. |
| La taille du chapeau dans lequel le modèle pioche le mot suivant : seulement les plus probables, ou un choix plus large. | Réglez soit la température, soit |
| La longueur maximale de la réponse, réflexion comprise chez la plupart des fournisseurs. | Gardez de la marge, surtout avec un modèle de raisonnement. |
| Freinent les répétitions de mots. | Utile si le modèle radote. Trop fort, le texte devient bizarre. |
| Rejoue le même tirage pour la même demande. | Pratique pour tester. La reproductibilité n'est pas garantie sur tous les modèles. |
| Une suite de caractères qui arrête la génération. | Rarement utile depuis les schémas JSON. |
| Le format imposé : JSON, ou JSON qui suit un schéma (le moule). | À utiliser dès que du code lit la réponse. |
| Active, règle ou coupe la réflexion. | Bas ou coupé pour les tâches simples. |
Le curseur de la créativité
Retour aux noms de recettes. Avec le prompt « description », j'ai lancé chaque modèle cinq fois à température 0,1, puis cinq fois à 1,2 :
- Gemini à 0,1 : trois fois sur cinq mot pour mot, une quatrième à un mot près, « Le riz qui a fait la fête hier soir avec ses nouveaux amis du frigo ». Un stagiaire au garde-à-vous ;
- Gemini à 1,2 : cinq noms différents, de « La symphonie du riz solitaire qui a trouvé des potes au frais » à « La fin tragique du riz solitaire qui a fini par danser avec un poivron égaré ».
Pour une fiche recette, où le nom est là pour faire sourire, la température haute est le bon choix. Pour une appli qui remplit une facture, ce serait une catastrophe. Et remarquez ce que la température n'a pas réglé : les 30 fiches de ce test étaient toutes bien formées, à 0,1 comme à 1,2, grâce au moule. Le format ne se règle pas au curseur, il se moule.
Le piège des réglages ignorés
Et Claude Haiku ? À 1,2, il a renvoyé trois fois sur cinq exactement le même nom : « Le riz d'hier refuse de finir à la poubelle ». Aucun effet visible du curseur. Et pour cause : sur la fiche du modèle chez OpenRouter, temperature ne figure pas dans la liste des paramètres pris en charge.
Chez OpenRouter, par défaut, un fournisseur qui ne connaît pas un paramètre reçoit quand même la demande, et ignore simplement les paramètres inconnus. Pas d'erreur, pas d'avertissement : votre curseur bien réglé n'a jamais été lu. Si un réglage compte vraiment, activez l'option require_parameters, qui n'envoie la demande qu'aux fournisseurs capables de le respecter. Je l'ai essayée sur Claude Haiku 5.5 et GPT-5.4 Nano, avec une température de 0,1 : les deux demandes ont été refusées, avec un message clair, « No endpoints found that can handle the requested parameters ». Un refus franc vaut mieux qu'un réglage avalé en silence.
La recette finale de Frigo Chef
Après sept étapes, voici ce que Frigo Chef envoie à chaque fois :
- La fiche de briefing en prompt système : rôle, contexte avec le placard et le pourquoi, tâche, format en consigne positive.
- Le contenu du frigo en message utilisateur, et l'historique de la conversation quand on demande une variante.
- Le moule : le schéma JSON, avec
strict: true. - La vérification des valeurs après réception, avant d'afficher quoi que ce soit.
- La réflexion coupée et un plafond de tokens confortable : c'est un riz sauté, pas une démonstration mathématique.
- Une température un peu haute pour des noms qui changent, sur un modèle qui l'accepte vraiment, avec
require_parameterspour en être sûr.
Rien de tout ça n'est de la magie, ni du code compliqué. C'est une fiche bien remplie, et une méfiance raisonnable envers ce qui revient.
À faire, à éviter
À faire :
- Écrire le prompt pour un stagiaire brillant qui ne sait rien de votre situation : rôle, contexte, tâche, exemples, format.
- Dire pourquoi, pas seulement quoi, et donner les limites (le placard !).
- Formuler en positif : « commence par
{» plutôt que « pas de Markdown ». - Séparer clairement consignes, exemples et données (titres ou balises).
- Mouler le format avec un schéma dès que du code lit la réponse, puis valider les valeurs.
- Mettre les longs documents en haut et la question à la fin.
- Lire le vrai nombre de tokens dans la réponse de l'API, et noter le modèle utilisé.
- Tester chaque prompt plusieurs fois, sur plusieurs modèles, et retester à chaque changement de modèle.
À éviter :
- Les exemples tous pareils, ou des exemples quand vous voulez de l'invention : ils seront copiés.
- Les consignes en majuscules et les « JAMAIS » empilés à la place d'une explication.
- Les très longues conversations qui changent de sujet en route.
- Régler la température et
top_pen même temps, ou dix paramètres « au cas où ». - Un plafond de tokens serré avec un modèle qui réfléchit.
- Croire qu'un réglage a été appliqué parce que l'API n'a pas protesté.
Le test des cinq minutes
Prenez un prompt que vous utilisez vraiment, au travail ou dans une appli, et faites ceci :
- Lancez-le cinq fois sur la même entrée. Les réponses ont-elles toutes la forme attendue ? Si non, le format n'est pas assez fermé.
- Donnez-le à lire à un collègue, sans contexte. Ce qu'il demande (« et le placard ? »), le modèle le devine.
- Cherchez les « ne pas » et réécrivez chacun en consigne positive, avec son pourquoi.
- Regardez vos exemples : sont-ils variés ? Retrouvez-vous leurs mots dans les réponses ?
- Vérifiez le nom du modèle, sa date de retraite, et les paramètres qu'il accepte vraiment.
Si votre prompt passe les cinq étapes, il est meilleur que la première version de Frigo Chef, qui en ratait quatre. Quant à mon frigo, la question est réglée : sur 129 fiches recettes, 128 avaient le mot « riz » dans leur nom. Ce soir, ce sera riz sauté. Les trois modèles sont d'accord, et c'est à peu près la seule chose sur laquelle ils le sont.
Sources
- Anthropic, Prompting best practices (clarté, contexte, exemples, balises, rôle, format, contexte long), Context windows et Structured outputs
- Anthropic, Effective context engineering for AI agents (pour aller plus loin sur la mémoire)
- OpenAI, Prompt engineering, Structured Outputs et la référence de l'API (température et
top_p) - Google, Gemini API : stratégies de prompt, Structured output, Thinking et Deprecations
- OpenRouter, API Parameters, Reasoning Tokens, Structured Outputs, Provider Selection et la liste des modèles (prix et paramètres pris en charge, relevés le 21 octobre 2026)
- DAIR.AI, Prompt Engineering Guide (en français : zero-shot, few-shot, chain-of-thought, chaînage et bien d'autres)
- Jason Wei et al., Chain-of-Thought Prompting Elicits Reasoning in Large Language Models (2022)
- Nelson F. Liu et al., Lost in the Middle: How Language Models Use Long Contexts (arXiv, 2023 ; TACL, 2024)
- Mes tests : Frigo Chef, un petit script Node.js écrit pour cet article, lancé le 21 octobre 2026 via l'API d'OpenRouter sur
google/gemini-3.1-flash-lite,anthropic/claude-haiku-5.5etqwen/qwen3.8-flash(plusopenai/gpt-5.4-nanopour l'essai derequire_parameters) : 157 appels, 7 centimes de dollar, cinq essais par réglage et par modèle. Les premiers appels àmistralai/mistral-small-2603n'ont renvoyé que des erreurs de quota et ne sont pas comptés. Un petit échantillon, à lire comme une anecdote mesurée, pas comme une étude. - Illustrations dessinées avec Excalidraw ; les personnages viennent de la bibliothèque Simple Characters de Peter Hunter et la loupe d'une bibliothèque de ferminrp, sur libraries.excalidraw.com (licence MIT) ; le frigo, la toque et les ciseaux viennent de Tabler Icons (licence MIT)
Je suis Loïc Simon, développeur web freelance en Bretagne. Je reprends, sécurise et documente les applications web laissées en plan par leurs développeurs d'origine ; j'en parle sur dev-relax.com. Comme le reste de mon travail, cet article a été écrit avec l'aide d'un assistant IA, puis relu et vérifié par moi ; les tests de Frigo Chef ont été lancés pour l'article, et les citations renvoient à leurs sources, vérifiées le 21 octobre 2026. Une erreur ? Dites-le-moi.